在我们继续取得进展的同时,8 月对于 availability 来说是一个充满挑战的月份。你可以阅读我们上个月发布的一篇 blog post,进一步了解这些 incidents。我们正在积极投资于架构改进以及迁移到 Azure,这将为我们带来更多 capacity。与此同时,我们平台仍在持续显著增长。我们正在优先处理影响最大的工作,同时尽量降低风险,但正如 8 月的这些 incidents 所表明的,我们无法完全消除风险。
最终,所有工作都需要完成,而 incidents 给了我们调整优先级的机会。作为这些 incidents 的修复项,我们在 capacity monitoring and management 方面做出了重大改进,改进了导致更大影响的 retry policies,并对 core services 做出了 resiliency improvements。我们也在许多 durable work streams 上继续取得很大进展。
8 月 11 日,GitHub 首次从 Azure 运行 production MySQL primary。Client 观察到的 write impact 很小,且切换过程中没有发生 customer impact。8 月 27 日,我们又以另外两个 primaries 重复了这一模式。未来几周我们还安排了更多 primaries,随着我们从每次 failover 中学习,复杂度也会增加。
Read traffic 也达到了新高。来自 migrated services 的 reads 峰值达到 60.4%,而来自 GitHub 的 monolith 的 reads 在 Azure 中峰值达到 64.3%。Git reads 达到 54%。
在 regional migration 之外,24-table authentication-core cohort 已从 GitHub 最古老的 shared database mysql1 迁出,从其 replicas 上移除了约每秒一百万次 queries。单独的 query-hygiene 变更又移除了每秒 120,000 次 queries,并每小时消除了约 59,000 秒浪费的 database work。
GitHub Actions 获得了额外的 capacity,而更长期的 isolation 工作仍在继续。Job-routing 变更将 33% 的 jobs 从一个受限的 production cluster 移至 spare capacity,使峰值 cache CPU utilization 从 98% 降至 80%,并增加了估计三个月的 headroom。这是一项近期的 containment measure,而不是终点;8 月的 outage 强化了对更持久的 capacity 和 isolation 的需求,相关工作仍在继续。
Pull request isolation 工作仍在继续。除了已经在服务的 unauthenticated traffic 之外,现在第一个 production cohort 的 authenticated reads 达到了 100%。
对 Git overload protection 的投资服务了多 6.4% 的 traffic,同时将 95th-percentile duration 改善了 24%,将 maximum delay 改善了 78%。edge 上更广泛的 load-shedding protections 也取得了进展,启用了可以在 unexpected load 下保护 GitHub 的 levers——事实上,这些 protections 被用于缓解 8 月前述的 incidents。
我们还改进了 monitoring 和 telemetry。Pull request monitoring 现在会独立衡量 merge、review 和 comment failures,否则高 read volume 可能会掩盖正在失败的 write path。8 月 21 日,自动化的 high impact incident detection 开始将 customer-support signals 与 service telemetry 结合起来。API monitoring 也经过了重新校准,并在 30 天内验证,减少了 noise,提高了 signal quality。这些变更改善了 detection 和 response。
下个月的工作包括迁移下一批 database primaries,继续将 services 及相应 traffic 迁移到 Azure,逐步改善 database health,尤其是 shared-databases,围绕 capacity management 和 auto-scaling 增加更多 automation,并将 dependency-failure handling 扩展到更多的 pull request experience。
这条原则继续指引我们:availability,然后是 capacity,然后是 features。
8 月 06 日 15:22 UTC(持续 10 小时 42 分钟)
发生了什么?
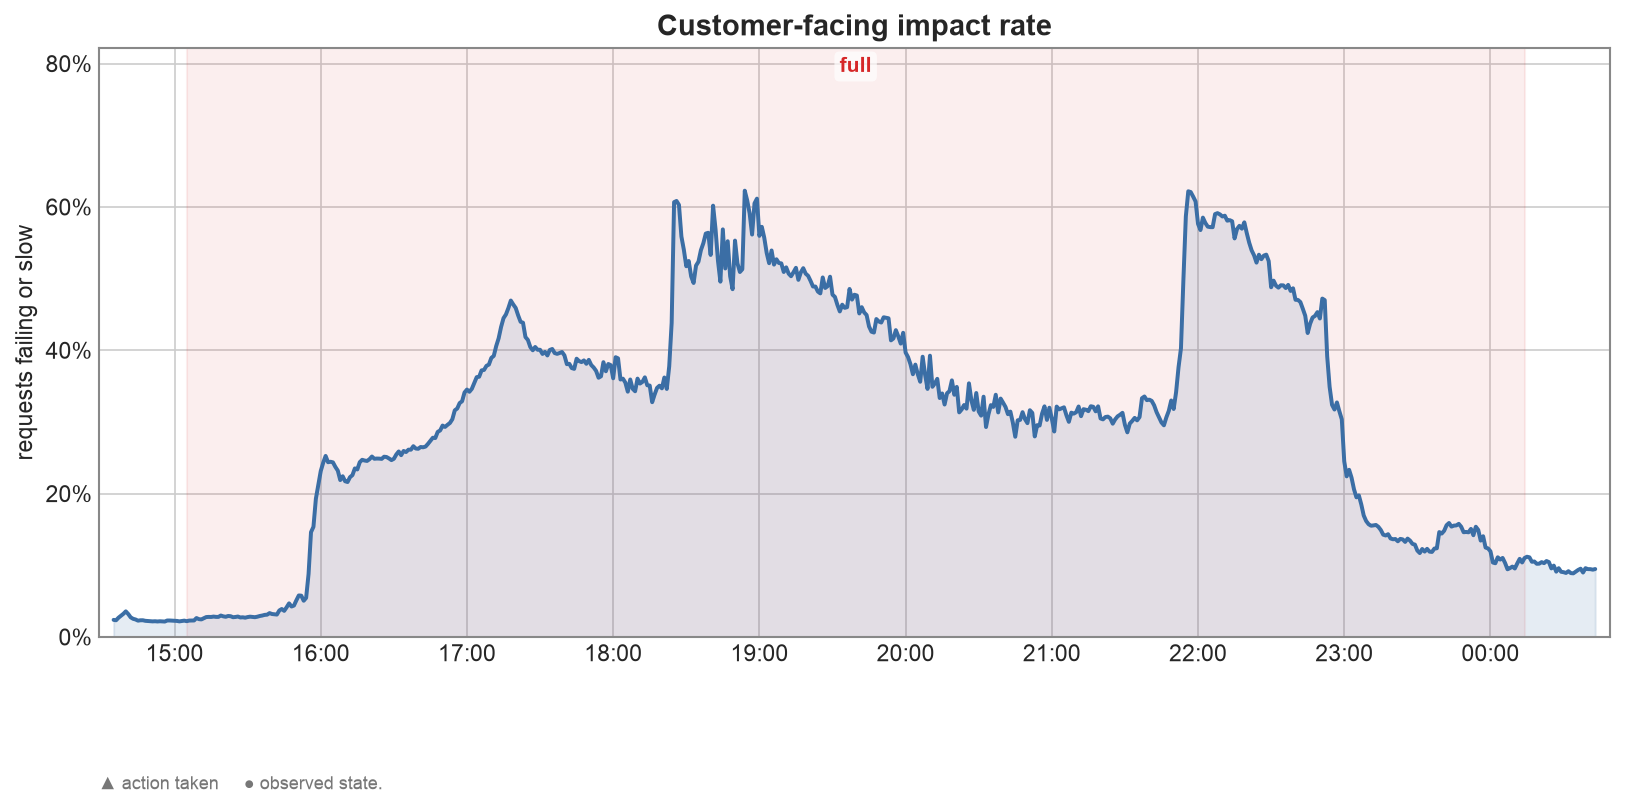
这起 incident 始于对一项内部 GitHub Actions service 的例行 deployment,该 service 处理传入 events 并将它们转换为 actions jobs。Deployment 的内容并无问题(我们将其 rollback 以确认这一点);相反,rollout 期间替换 pods 短暂降低了一个 site 的 capacity,并在 traffic 转移到其余 sites 时将它们推过了 limit。影响在 incident 中段最为严重,当时很大一部分 actions workflow runs 无法启动或完成。
出了什么问题,以及为什么?
受影响的 actions services 运行时已接近其 capacity 和 concurrency limits。一次例行的 deployment 短暂减少了正在运行的 pods 数量,就足以耗尽可用的 headroom。这导致 service mesh sidecars 遭遇 CPU throttling 和 out-of-memory restarts,随后级联成多个 clusters 中的 cache、DNS 和 API errors。这些 services 的 ingress service mesh headroom 有限,因此无法吸收 deployment 期间临时的 capacity 损失。
当 core services 恢复时,job-assignment path 中的一个 latent bug 使恢复变慢:runners 被分配了已经被 revoke 的 jobs,然后卡在重试这些 jobs 上,而不是接手有效工作,从而造成了自我放大的 backlog。
我们如何响应?
- 一次对内部 actions service 的例行 deployment 短暂降低了一个 data center 的运行 capacity,几分钟内 service mesh 和剩余 pods 就饱和了。
- 随着 cache、DNS 和 API errors 扩散,actions infrastructure failures 攀升,failures 在 clusters 间级联。我们宣布了 public incident,确定了触发它的 deployment,并将其 rollback 以确认其内容不是原因。
- 在大约接下来的两个小时里,我们为饱和的 services 扩展了 capacity,并对传入的 webhook-triggered work 进行 throttle,以便系统稳定下来。
- 随着 core services 恢复,仍积压了大量排队的 jobs。一个 latent bug 导致 runners 被分配到不再有效的 jobs,然后卡在重试它们上,阻碍了真正的工作。
- 我们部署了 fixes,使 runners 不再尝试获取无效的 jobs,清空了累积的 queues,并提高了拖慢恢复的内部 rate limits。Workflow success rates 回升至接近正常。
- 系统范围的 queues 被清空,actions 恢复正常运行。较少数量的 self-hosted runners 仍然卡住,并被手动恢复;incident 期间的一些 events 无法自动 replay,必须重新触发。
我们如何让这类 incidents 更不可能发生或影响更小?
- 为 service mesh ingress 和受影响的 actions services 增加 headroom 并启用 autoscaling,使一次例行 deployment 无法将它们推向饱和。
- 通过避免在 rollout 期间减少 capacity,使这些 services 的 deployments 更安全。
- 加强对 incident 之前出现的饱和和 database-proxy 状况的 monitoring,以便更早发现。
- 改进系统在大型 actions incidents 期间 shed load 和清空 backlogged work 的方式,并防止 runners 卡在重试无效 jobs 上。
- 在即将发布的 runner 和 ARC releases 中,为受此 failure mode 影响的 self-hosted Actions Runner Controller runners 交付 automatic recovery。
8 月 17 日 13:40 UTC(持续 7 小时 35 分钟)
发生了什么?
出了什么问题,以及为什么?
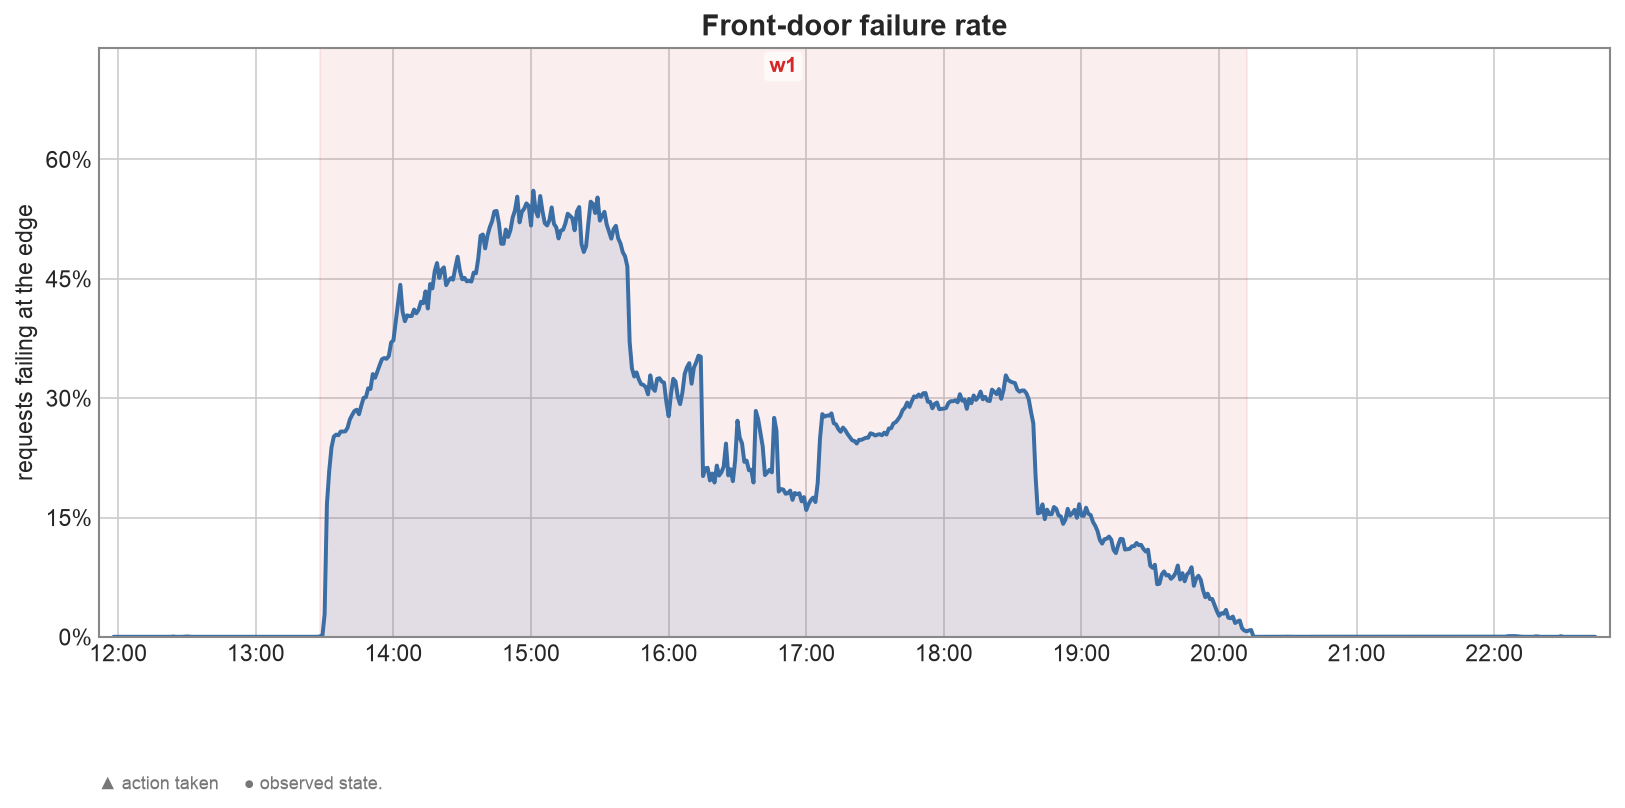
新的 traffic 峰值将一个 datacenter 的 load balancers 推过了其 limits。一个 service-mesh sidecar 达到了其 concurrency limit,且没有 scale up。
随着 requests 积压,该 datacenter 的多个 load-balancer nodes 耗尽了其 network flow limits,这降低了 shared gateway authentication path 的性能,并在许多经由该 datacenter 路由的 services 中产生了广泛的 authentication latency 和 failures。
一个 latent client retry bug 急剧放大了流向一个内部 authentication endpoint 的 traffic,拖慢了 Copilot Token Service 的恢复。核心弱点是我们的 service-mesh sidecar 没有 scale up,再加上我们的 retry behavior,并且 clients 没有足够的 bound 来阻止局部 degradation 放大为更广泛的 overload。
我们如何响应?
- 新的 traffic 峰值将一个 datacenter 的 load balancers 推向其 limits;一个 service-mesh sidecar 达到其 concurrency limit,并且无法 scale up。
- 随着多个 load-balancer nodes 耗尽其 network flow limits,shared authentication path 性能下降,overload 级联;issues、pull requests、APIs、actions、Copilot 和其他 services 开始返回 errors 和缓慢响应。
- 自动 monitoring 检测到升高的 errors,并开启了一个 incident;随着来自受影响 services 的 engineers 汇聚,受影响产品在 public status page 上被标记为 degraded。
- Engineers 将 failure 追踪到单个 datacenter 中 load balancers 上的 network saturation,并开始将部分 traffic 转移到另一个 datacenter,同时减少 gateway retries 以缓解压力。
- 团队停止饱和 nodes 上的 load-balancer processes,并阻断发往受影响最严重的 internal endpoint 的 retry-triggering requests,这带来了广泛且立即的恢复。
- 由 client retry amplification 驱动的剩余 authentication errors 通过逐步提升 traffic 而稳定下来,在持续一段时间的健康 telemetry 后,incident 得到解决。
我们如何让这类 incidents 更不可能发生或影响更小?
- 修正 autoscaling policies,使其考虑 service-mesh sidecar 的 concurrency 和 capacity,而不仅仅是 host service。
- 审计受影响的 services 中 service mesh 的 request、concurrency 和 scaling limits。
- 审查 gateways 和 clients 中的 retry 和 backoff limits,使局部 degradation 无法放大为更广泛的 overload。
- 修复在 incident 期间放大了 authentication traffic 的 client retry behavior。
- 改进 load-balancer capacity monitoring,并加强 regional failover safeguards。
8 月 20 日 14:43 UTC(持续 9 小时 54 分钟)
发生了什么?
在 incident window 期间,Copilot cloud agent task 受到影响。Tasks 本身仍然运行至完成,因此没有丢失任何工作。一旦处理赶上来,正确的 status 和 results 就会出现。等待一小段时间,或稍后再查看,就会显示最新状态。
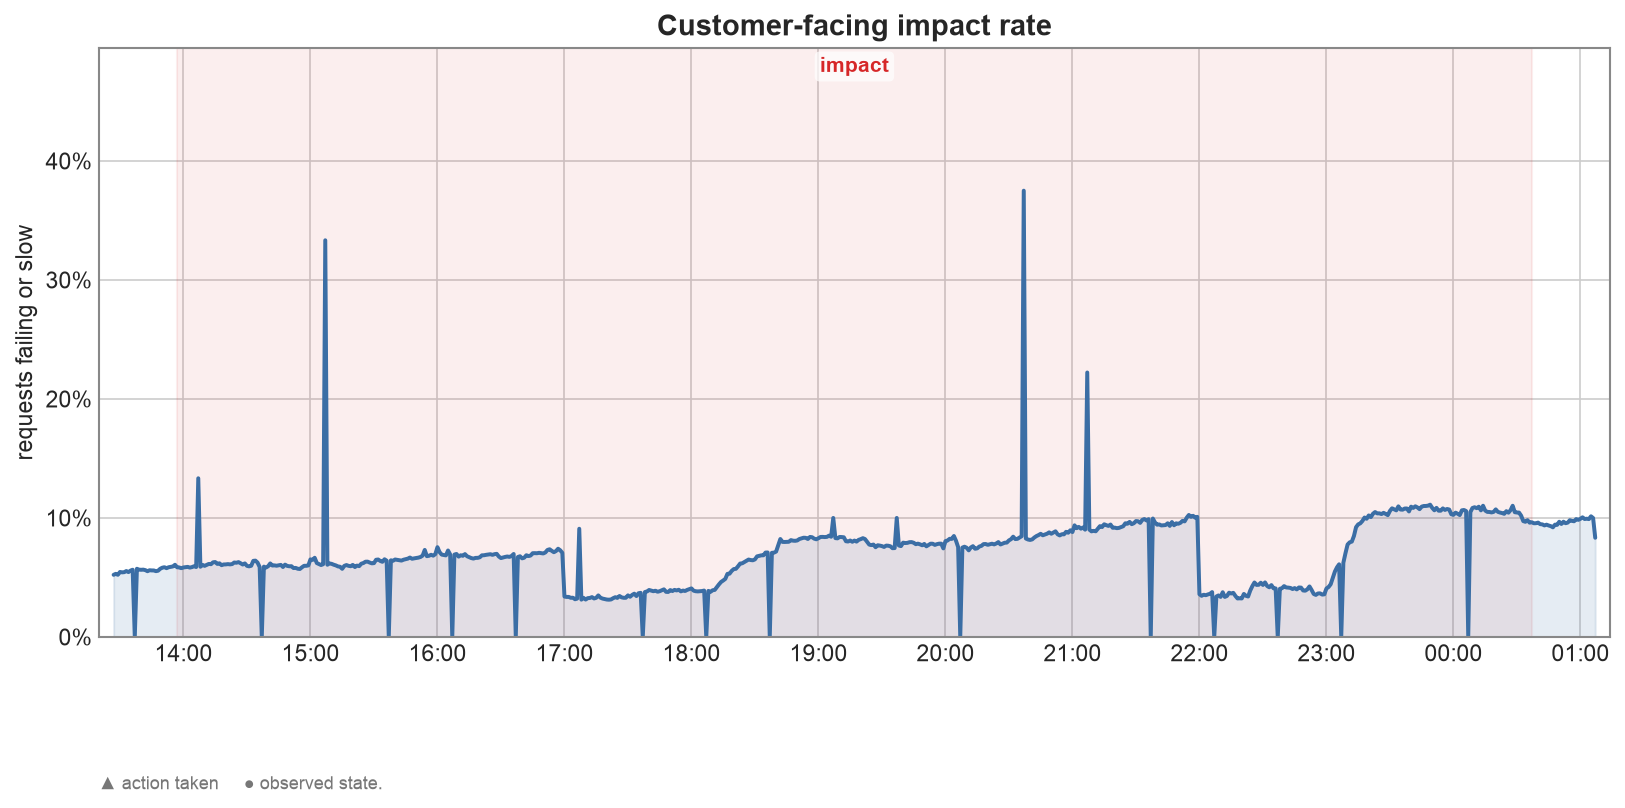
在整个 incident 期间,至少有 54 个 organizations 遭遇 Copilot Cloud Agent task status 和 results 明显高于其自身正常水平的滞后。按分钟计的 customer-facing impact 峰值达到所测量 task-status activity 的 37.5%。
出了什么问题,以及为什么?
Copilot cloud agent 将每个 agent task 的 status 和 results 存储在一个 managed cloud database 中。该 database 的一个 region 遭遇了 provider-side outage,受影响 region 中读取和写入 task status 的 calls 开始失败并运行缓慢。
随着 database latency 攀升,将 task-status updates stream 到该 database 的 processors 随后落后了。它们的 throughput 受限于固定数量的 processing partitions,这些 partitions 的大小是按正常 latency 加一些 headroom 设计的。本次 incident 中的 latency 远远超出了该 headroom,导致 task-status updates 的 backlog 不断增长而非清空。该 database 上的一项 storage configuration 还使受影响 region 的 fail over 变得缓慢,因此最初的 failover attempts 没有生效,恢复耗时也比预期更长。
我们如何响应?
- 存储 Copilot cloud agent task status 的 managed cloud database 的一个 region,在 provider-side regional outage 后开始失败并运行缓慢。
- On-call engineers 被 paged,开启了一个 incident,并将 errors 追踪到受影响的 database region。
- Engineers 开始了 regional failover,但它没有生效——database 上的一项 storage configuration 使该 region 移动缓慢——因此 task-status updates 持续积压。
- 团队强制将受影响 region 下线,并将 task-status processing 转移到一个 healthy region;write latency 仍然偏高,而 backlog 使 status view 持续延迟。
- 增加了额外的 streaming capacity,且 provider 的 region 逐渐恢复,使 processors 能够处理完 backlog,从而让 task status 和 results 赶上来。
- Latency 恢复正常,backlog 清空,incident 得到缓解并解决。
我们如何让这类 incidents 更不可能发生或影响更小?
- 移除使受影响 region 的 fail over 缓慢的 database storage configuration,以便能够快速脱离单个 region 的问题。
- 改进此 database 的 regional failover runbooks,包括一份经过审核、按顺序排列的 fallback regions 列表,以保持 service 健康。
- 审查 failover priority,使 failover 期间选择的下一个 region 是次优的 healthy 选项。
- 使 task-status streaming 对升高的 database latency 更具弹性,这样 latency spike 不会立即 throttle throughput 并形成 backlog。
- 改进 managed databases 上的 monitoring 和 escalation。
8 月 26 日 15:11 UTC(持续 2 小时 50 分钟)
发生了什么?
依赖 services,例如 Copilot code review 和某些运行在 actions 之上的 GitHub Pages deployments,在 incident window 期间受到影响。
在大多数情况下,延迟的 runs 在 backlog 清空后启动,而未能启动的 runs 在 incident 后重新运行后成功。少数在 incident 最早阶段创建的 runs 无法通过重新运行恢复,必须重新启动。
出了什么问题,以及为什么?
简要总结是,我们的 shared infrastructure services 未能跟上我们逐月的 actions 增长和 peak load。
在已经很高的 load 之上,又涌入了一波 incoming events,将 database 推过其 tipping point。Query times 攀升,database primary 饱和。
由于 database 过载,将 incoming events 转换为 runner assignments 的 internal service 无法跟上,因此 actions runs 无法启动,并开始排队,远超其正常开始时间。
对 database primary 进行 failover 只起到了部分帮助。用于缓解 inbound load 的 throttles 最初设置得略高,无法完全保护 database,因此恢复必须缓慢且手动地逐步提升。
当 database 显示出早期压力迹象时,没有 automatic circuit breaker 来 throttle inbound actions load,因此在 incident 期间,保护性 throttling 必须手动施加和调整。这是本次 incident 的 learnings 之一。
我们如何响应?
- 在一次每日 traffic peak 期间,一波 incoming events 涌入,而 actions 依赖的一个 shared database 已经运行在接近其 limit 的状态。database primary 上的 write 和 query pressure 急剧上升并开始饱和。
- 将 incoming events 转换为 runner assignments 的 internal service 无法再跟上。Actions runs 开始失败,并开始了 incident investigation。
- 我们将 database primary fail over 到一个 replica。这短暂改善了情况,但没有完全缓解,因此 runs 继续失败或延迟启动。
- 我们对 inbound event processing 进行 throttle,以缓解 database 的压力并让它恢复。一旦 throttling 和 service restarts 生效,core service health 就恢复了,尽管 inbound work 现在被有意放慢。
- 我们逐步提高 throttles,并在每一步观察 telemetry,以免再次压垮 database,直到完整的 event processing 恢复,延迟工作的 backlog 清空。我们将 incident 标记为 mitigated。
- 较大和 self-hosted runners 上的一部分 jobs 仍然卡住,等待一个 runner。我们部署了一项变更来释放它们,并继续进行后续工作,以清理那些一直显示为 queued 的 runs。
我们如何让这类 incidents 更不可能发生或影响更小?
- 通过优化 client code 中的特定 code paths,提高 database usage 的 query efficiency。
- 增加一个 automatic circuit breaker,用于 throttle inbound actions load
来源:GitHub Blog